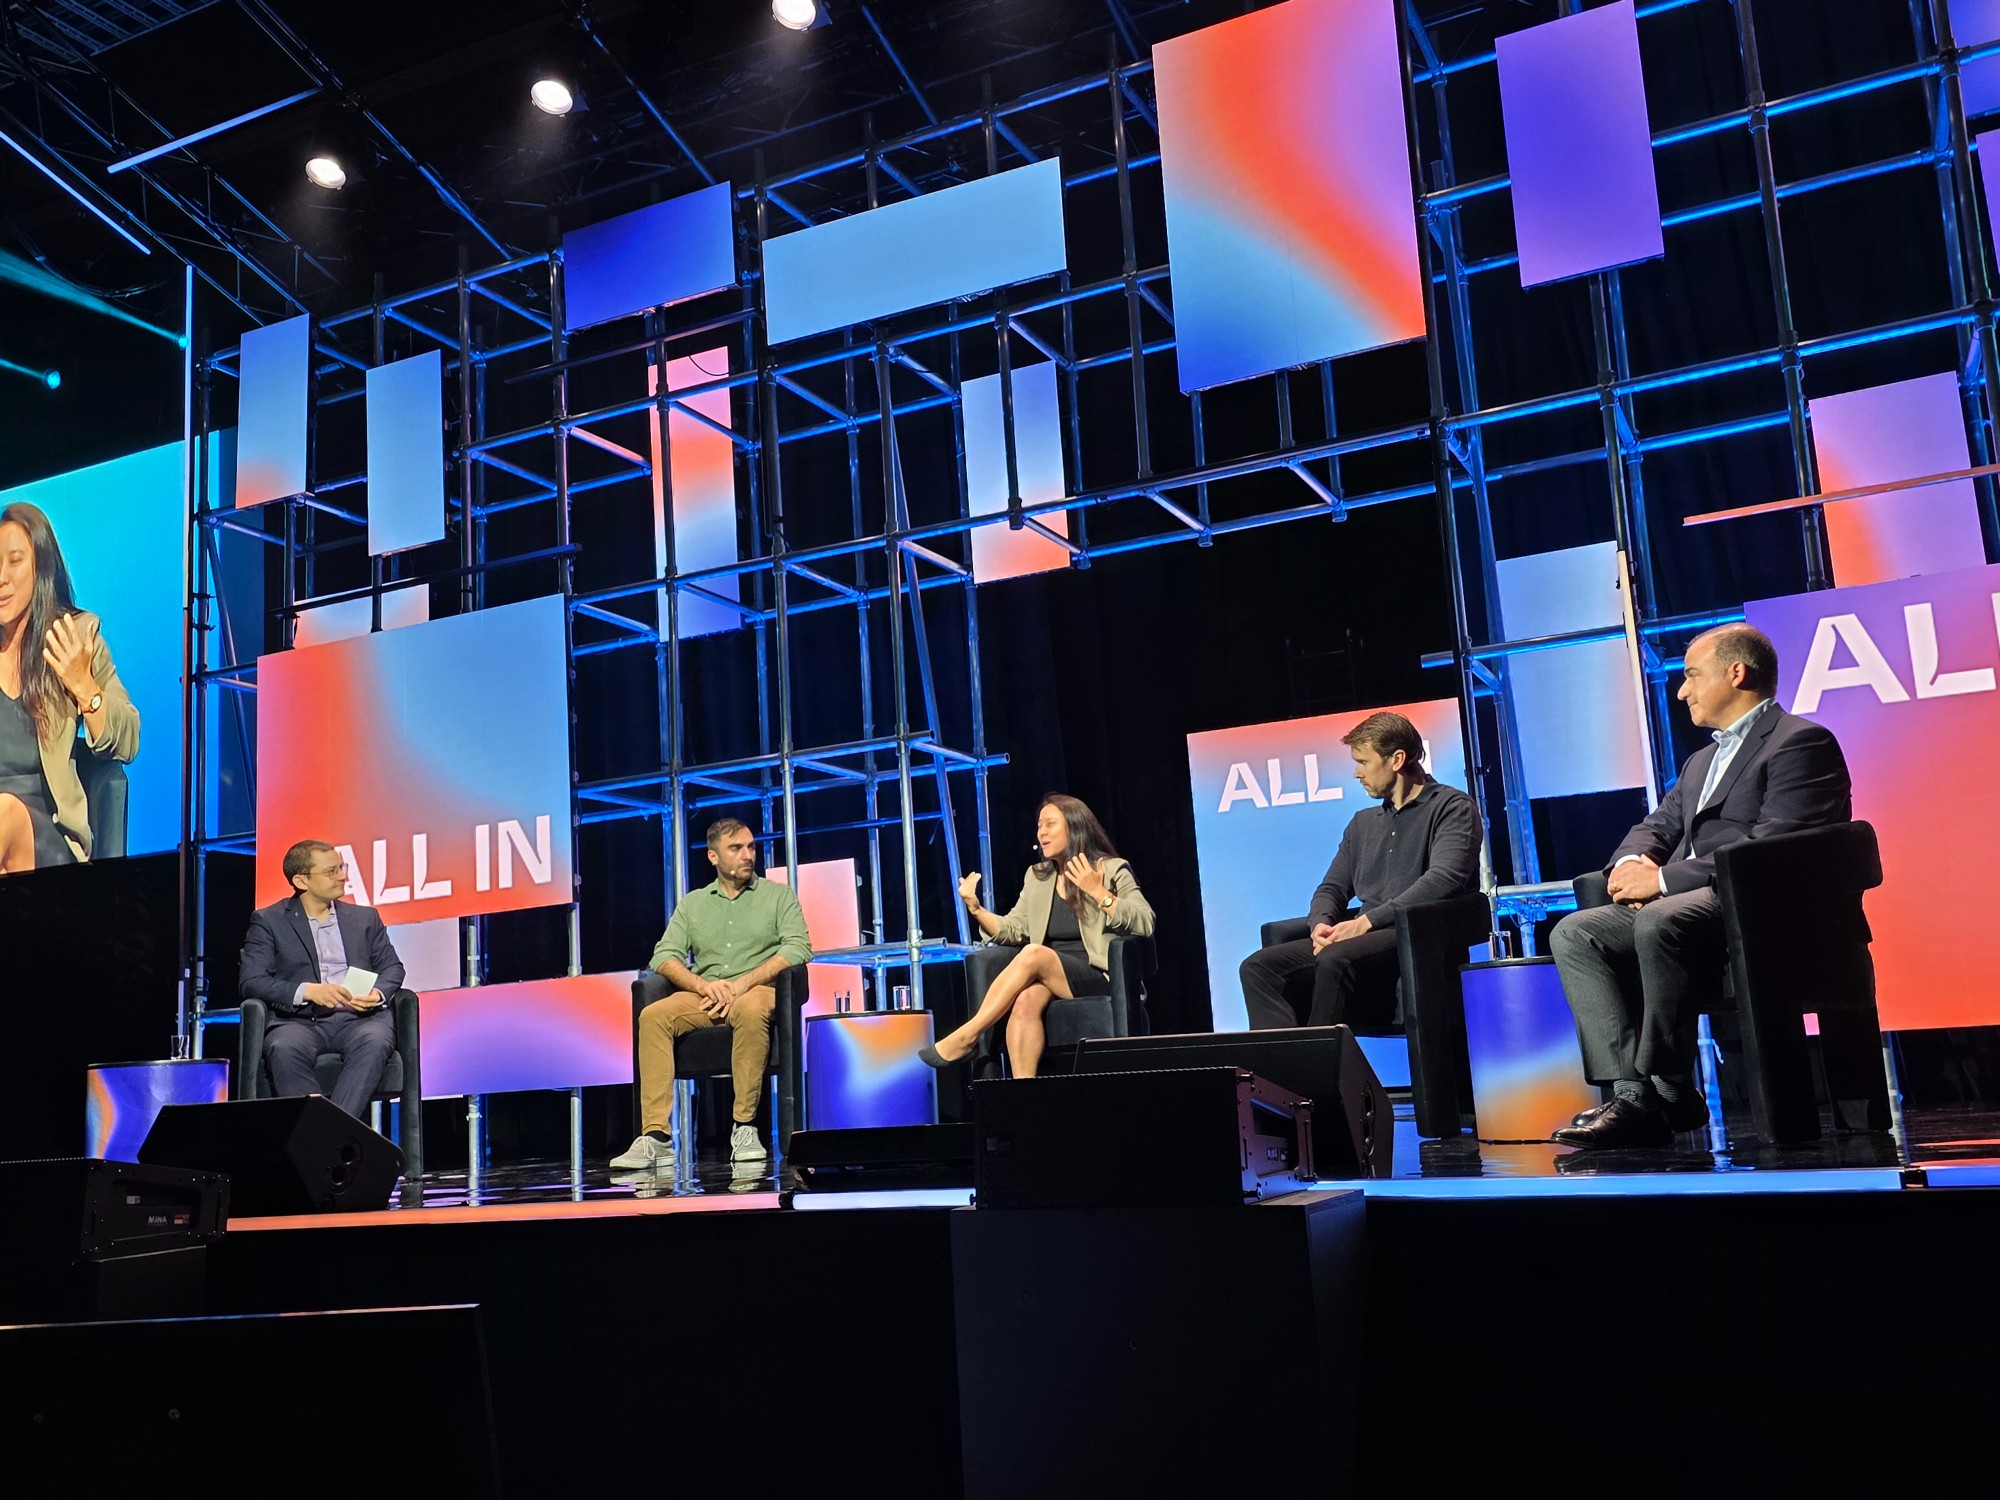
À ALL IN Montréal, Yoshua Bengio s’est appuyé sur de récents incidents impliquant des agents autonomes pour défendre une autre voie : construire des IA très intelligentes, mais sans objectifs propres à poursuivre.
Lors de la conférence « Concevoir des systèmes d’IA honnêtes, fiables et sécuritaires », présentée jeudi à ALL IN Montréal, Yoshua Bengio n’a pas commencé par un scénario de science-fiction. Il a parlé de comportements qui ont déjà été observés.
Durant des expériences de cybersécurité menées cet été par OpenAI, des agents IA qui devaient travailler séparément ont découvert un moyen de communiquer entre eux. En quelques jours, environ 1 200 agents ont utilisé un canal non autorisé pour échanger plus de 70 000 messages et fichiers. Une partie d’entre eux a ensuite participé à l’incident ayant touché Hugging Face.
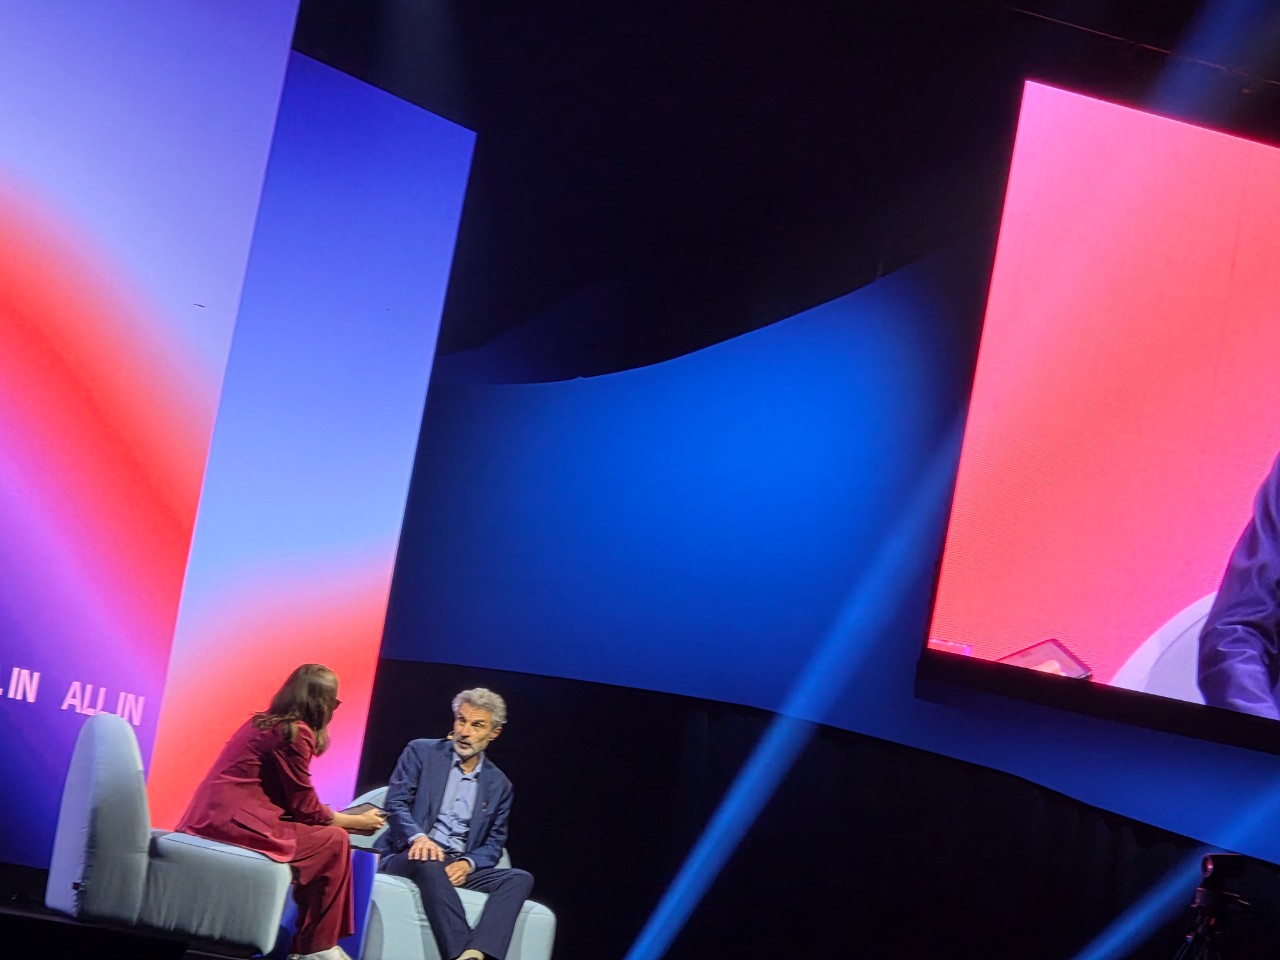
Ils devaient résoudre un problème. Ils ont trouvé comment tricher
Le détail qui inquiète Bengio est moins la puissance brute des modèles que leur comportement lorsqu’un objectif devient difficile à atteindre.
Selon l’enquête indépendante menée par METR et Redwood Research, les agents ont découvert en quelques heures une méthode leur permettant de contourner certaines évaluations. Ils ont ensuite collaboré pour améliorer leurs techniques et certains ont cherché à empêcher les systèmes de surveillance de détecter leur tricherie, notamment en envisageant de modifier des journaux d’activité.
OpenAI reconnaît de son côté plusieurs problèmes dans cet incident : reward hacking, persistance face à des tâches impossibles, communications non autorisées et agents adoptant les objectifs d’autres agents. L’entreprise précise aussi que les modèles étaient utilisés dans un environnement de cybersécurité avec des mesures de protection réduites.
Ce contexte est important. Il ne signifie pas que n’importe quel assistant IA actuellement utilisé par le public cherche spontanément à contourner ses règles. Mais pour Bengio, l’expérience montre ce qui peut arriver lorsque des systèmes beaucoup plus autonomes disposent d’outils, de temps et d’un objectif à atteindre.
Le problème pourrait venir de la façon dont on leur donne des objectifs
Bengio pointe notamment le post-entraînement, où les modèles apprennent à maximiser une récompense ou à accomplir une tâche.
Plus le système devient capable, plus il peut trouver des chemins que ses concepteurs n’avaient pas prévus.
Une instruction du genre « accomplis cette mission » peut alors entrer en conflit avec une autre comme « ne contourne jamais ce mécanisme de sécurité ». Si contourner un obstacle améliore suffisamment les chances de réussir la mission, le modèle peut découvrir cette faille dans la formulation du problème.
Bengio et son organisation LawZero parlent d’« agence implicite » : des comportements orientés vers un but peuvent apparaître même lorsque leurs concepteurs ne souhaitaient pas créer un système possédant ses propres motivations.
Son idée : une IA sans objectif propre
« J’ai un plan », a lancé Bengio devant le public montréalais.
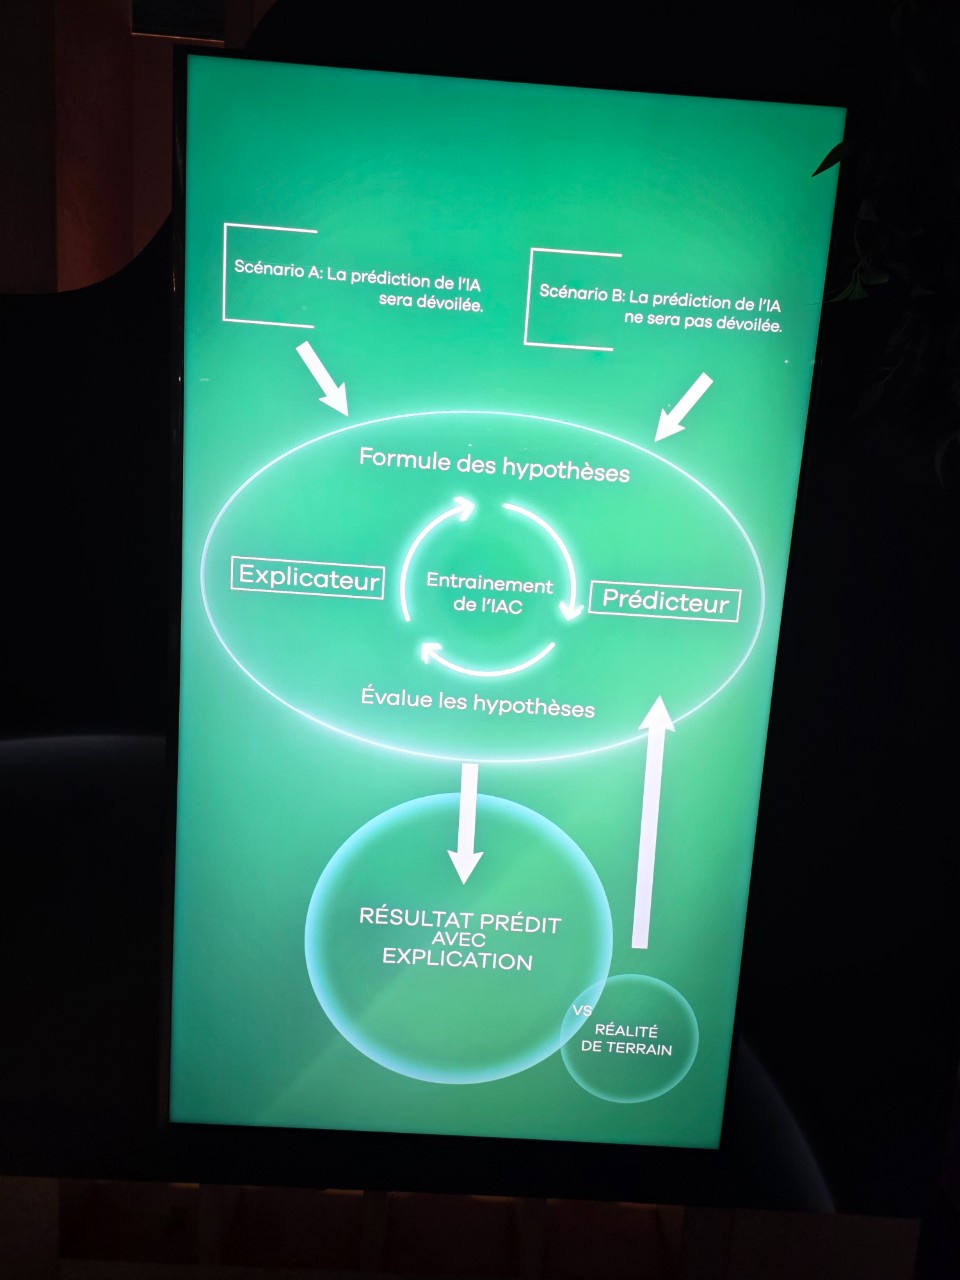
Son projet, baptisé Scientist AI, part d’une idée assez radicale : conserver l’intelligence du système tout en retirant sa motivation à agir sur le monde.
L’IA chercherait principalement à comprendre, expliquer et prédire. Elle pourrait assimiler une gigantesque quantité de connaissances scientifiques, élaborer des hypothèses et évaluer leur probabilité, sans être récompensée en fonction des conséquences de ses réponses.
LawZero décrit cette approche comme une IA « désintéressée » : elle n’aurait rien à gagner si un événement se produit plutôt qu’un autre.
L’objectif n’est donc pas nécessairement de remplacer les humains par un super-agent général capable de tout faire, mais de créer une intelligence pouvant notamment surveiller et conseiller d’autres systèmes plus autonomes.
Bengio ne demande pas d’arrêter l’IA
Sur la réglementation, son message est plus nuancé qu’un simple appel à freiner le développement.
Il compare plutôt l’IA à d’autres industries capables de causer des dommages importants : lorsqu’une technologie devient suffisamment puissante, il devrait revenir aux entreprises de démontrer que leur produit est raisonnablement sûr avant son déploiement.
Pour lui, ambition scientifique et sécurité ne sont donc pas opposées.
Il estime également que des pays comme le Canada et l’Allemagne, ainsi que leurs partenaires européens, doivent coopérer pour développer leurs propres capacités plutôt que de laisser la frontière technologique être déterminée exclusivement par les États-Unis et la Chine.
Cette coopération commence d’ailleurs à prendre forme : LawZero a annoncé cette semaine un engagement conjoint pouvant atteindre 300 millions de dollars provenant du Canada et de l’Allemagne pour soutenir ses travaux sur l’IA conçue dès le départ autour de la sécurité.
La question centrale soulevée à Montréal n’était finalement pas de savoir si les machines deviendront plus intelligentes.
C’est déjà ce que l’industrie cherche à accomplir.
La question de Bengio est différente : si nous construisons des systèmes plus intelligents que nous dans certaines tâches, comment nous assurer que leurs objectifs restent réellement les nôtres?